Integratieplatform — één runtime, twaalf koppelingen
Een grote Nederlandse supermarktketen, vanaf 2021. Klant geabstraheerd; scope en metingen zoals geleverd.
Context
Het landschap had koppelingen verzameld zoals de meeste landschappen dat doen: één voor één, elk een klein maatwerkproject. Elke koppeling implementeerde opnieuw authenticatie, retry en dead-letterafhandeling, en elke koppeling had zijn eigen idee van wat een fout was. Dat is betaalbaar bij drie koppelingen en duur bij dertig. De code is niet moeilijk. Het probleem is dat niets gedeeld wordt, dus elke storing wordt vanaf nul onderzocht door wie het ooit bouwde.
De lastige randvoorwaarde was dat de teams die deze koppelingen bouwden niet één team waren. Ze zaten in verschillende domeinen, op verschillende backlogs, met verschillende definities van klaar.
Wat ik bouwde
Een configuratiegedreven integratieplatform op AWS, waar een koppeling configuratie is in plaats van een codebase:
- Eén runtime, veel koppelingen. Eén set Lambda-functies bedient elke koppeling. Koppelingen verschillen alleen in Terraform-configuratie, een mappingbestand en een schema; er een toevoegen raakt geen runtimecode.
- Een fetch → transform → publish-pipeline, waarbij elke stap wordt gestart doordat het object van de vorige stap in S3 landt, met per stap de status van de run vastgelegd zodat een half afgemaakte run zichtbaar is.
- Bronnen en bestemmingen als adapters: event-topics, REST-API's en bestandsdrops aan de ingang; REST, SOAP en event-topics aan de uitgang.
- Declaratieve mappings (JSONata), geversioneerd zodat achteraf te achterhalen is welke mapping een bepaalde payload heeft geproduceerd.
- Authenticatie in beheer van het platform: OAuth2 client-credential-flows, tokencaching en -rotatie, zodat een integratie-engineer nooit tokenlifecyclecode schrijft.
- Een beheer-API achter JWT-authenticatie: een dead-letterbericht opnieuw aanbieden, een koppeling pauzeren, een queue leegmaken, de status van een run bekijken. Open voor de teams die eigenaar zijn van de koppelingen, niet alleen voor het platformteam.
- Alerting op incidentprioriteit naar het kanaal waar de dienstdoende engineer al zit, met gestructureerde logs en traces erachter.
Impact
- Twaalf koppelingen in productie op één runtime, over warehouse-, supply-chain-, masterdata- en CRM-stromen.
- ~6,7 mln runs per maand, een dozijn functiefouten in 30 dagen (september 2026). De retry-, dead-letter- en idempotentie-afhandeling is gedeeld, dus elke koppeling test hem tegelijk.
- Drie van de koppelingen zijn tegelijk de ingestiefeed van het lakehouse. Dezelfde run die warehouse-events tussen operationele systemen vervoert, zet ze ook in Databricks, zodat het dataplatform het contract, de dead-letterafhandeling en de replay erft in plaats van ze opnieuw te bouwen.
- Tijd tot een nieuwe koppeling in productie: minder dan een werkdag, vanaf het schrijven van de mapping, tegenover het maatwerkproject van meerdere weken dat het verving.
- Foutafhandeling, observability en replay komen mee met het platform; niemand bouwt ze per koppeling opnieuw.
- Beheerders diagnosticeren en herhalen zonder consoletoegang of een ticket bij het platformteam.
Het patroon erachter
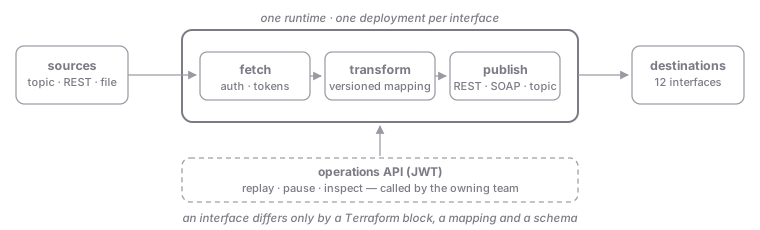
Het gebruikelijke bezwaar tegen een gedeelde integratieruntime is het juiste bezwaar: zet alles op één platform en één slechte wijziging legt alle stromen tegelijk plat. Dus de code is gedeeld en de deployment niet. Elke koppeling is een eigen stack met een eigen queue, eigen opslag en eigen alarmen, op identieke code. Een team dat het platform in gebruik neemt, erft de weg zonder andermans incidenten te erven.
De koppeling zelf is een mappingbestand en een Terraform-blok, gereviewd als elke andere wijziging. Dat is wat een nieuwe integratie van een project van weken naar een dag bracht, en het is ook wat governance afdwingbaar maakt, want de module is de policy. Beheer is om dezelfde reden selfservice en API-first: replay, pauzeren en inspecteren zijn endpoints die het eigenaarsteam zelf kan aanroepen. Dit was het deel dat adoptie mogelijk maakte, en het deel dat het makkelijkst was geweest om weg te laten. Een intern platform waarvan het beheer via het eigen team loopt, heeft de flessenhals alleen verplaatst.
We hebben ook gemeten voordat we naar een zwaardere runtime zouden gaan. De aanname in de kamer was dat serverless het niet zou houden en dat het platform containers nodig had. In plaats van erover te discussiëren heb ik een geschiktheidsonderzoek gedaan: sweeps tegen tijdelijke stacks op een bewust zware synthetische workload, plus een langdurige soak. Serverless verwerkte 122 berichten per seconde aanhoudend met ruimte over, bij 99,78% beschikbaarheid over een soak van 30 minuten. Echte productiekoppelingen zitten onder 1 bericht per seconde, en de zwaarste voorziene toekomstige op ongeveer 7–11. De beperkende factor bleek de verwerkingskosten per bericht, dus de migratie die niemand had begroot was ook een migratie die niemand nodig had.
Het plafond is expressiviteit. Alles wat de mappingtaal niet kan uitdrukken wordt óf een maatwerktransformer, een ontsnappingsluik dat het model een beetje uitholt elke keer dat het gebruikt wordt, óf een "nee". Het platform is geen algemene ETL-tool. Het verplaatst één bronrecord naar één bestemmingsaanroep, en aggregatie, fan-out en batch vallen buiten scope. Nee zeggen tegen het vierde speciale geval is wat de eerste drie goedkoop houdt.
Wie ja moest zeggen
Stakeholders: de domeinteams die eigenaar waren van de bestaande maatwerkkoppelingen en moesten migreren; het platformteam dat de runtime en de bijbehorende bereikbaarheidsdienst zou gaan dragen; de engineers die opgeroepen worden bij integratiestoringen; en de securityafdeling, omdat het platform nu de credentials van elk aangesloten systeem bewaart.
De onenigheid: een gedeelde runtime vraagt een domeinteam om code op te geven die het zelf beheert, en te accepteren dat zijn koppeling nu afhangt van een platform dat iemand anders uitrolt. Dat is een echt verlies aan autonomie, en de zorg over de impactradius erachter is terecht. Vanuit het platformteam was de zorg het spiegelbeeld: zij kregen een bereikbaarheidsdienst in de schoot geworpen voor stromen die ze niet hadden geschreven en waarvan ze de businessbetekenis niet kenden.
Wat het oploste: de teams meer operationele controle geven dan ze daarvoor hadden. Via de beheer-API kan een domeinteam zijn eigen koppeling opnieuw aanbieden, pauzeren en inspecteren zonder toegang tot de AWS-console en zonder een ticket, en dat is een betere positie dan eigenaar zijn van maatwerkcode die je om twee uur 's nachts vanuit CloudWatch moet debuggen. Eén deployment per koppeling beantwoordde het bezwaar over de impactradius structureel. En de scope van de bereikbaarheidsdienst van het platformteam werd vastgelegd als de runtime, niet de mappings: als een transformatie een verkeerd document oplevert, is dat een defect van het eigenaarsteam, en de runrecords maken het mogelijk die twee uit elkaar te houden.
Wat het kostte: het platformteam nam een runtime en een bereikbaarheidsrooster op zich die het eerder niet had, permanent. Elk domeinteam gaf de vrijheid op om een koppeling op te lossen zoals het zelf wilde. Die vrijheid was iets waard (het is waarom het landschap eruitzag zoals het eruitzag), en de ruil houdt alleen stand zolang het platform goedkoper blijft om te gebruiken dan het zelf te schrijven. Dat is een blijvende verplichting.
Rol & stack
Ontwierp en bouwde het platform: het runtimemodel, de mapping- en contractlaag, de beheer-API, de alertingroute en het geschiktheidsonderzoek achter de serverlessbeslissing.
Stack: AWS (Lambda, SNS/SQS, S3, DynamoDB, API Gateway, Secrets Manager, EventBridge), Terraform, Node.js/TypeScript, JSONata, OAuth2/OIDC, Datadog.
→ Dit is het platform waar de SAP-event-backbone naartoe publiceert; die casus is de grens waar een SAP-landschap zijn business events aan dit platform overdraagt. Zie ook Integratiearchitectuur en Werken door de organisatie heen.