Een kennislaag waar een advocaat op kan varen
Een taalmodel kan een goed juridisch antwoord schrijven. Het kan niet weten dat het kantoor deze cliënt in 2022 over deze vraag heeft geadviseerd, wie het werk deed, en wat de toezichthouder ermee deed. Die kennis zit verspreid over het dossiersysteem, het CRM, slotbrieven en het geheugen van de partners die erbij waren. De meeste plannen voor een knowledge graph onder een juridische AI-assistent beginnen bij het lezen van de documenten, en missen daarmee juist de kennis waar partners het meest aan hechten.
Dit is de architectuur die ik onder de assistent van een kantoor zou leggen, en ze rust op één regel: beslis wat iemand mag horen voordat je ook maar iets voor die persoon ophaalt. Ik heb haar op laptopschaal gebouwd als trusted-knowledge-graph. Een verzonnen kantoor met 400 dossiers, 150 cliënten, 60 advocaten en 772 documenten, met dezelfde standaarden en handhavingspunten die een echte bouw zou gebruiken, en elk getal in dit stuk geschreven door een make-target. Het draait zonder API-sleutel.
Vier soorten kennis, op vier plekken
| Soort kennis | Waar ze staat | Hoe ze in de graph komt |
|---|---|---|
| Toegepaste expertise: wie adviseerde wie, waarover, wanneer | dossierregistratie, tijdschrijven, documenten | de bronsystemen voor wie, wanneer en voor wie; extractie voor het onderwerp |
| Uitkomsten: de toezichthouder ging akkoord, de claim werd geschikt | slotbrieven, besluiten, het geheugen van partners | extractie, plus een vastlegmoment bij het sluiten van een dossier |
| Cliëntrelaties | CRM, e-mail, de hoofden van mensen | het CRM als bronsysteem; documenten voegen rollen en data toe |
| Standpunten en precedenten | memo's, kennisnotities | extractie, bevestigd door de praktijkgroep |
Alleen de laatste rij staat grotendeels in documenten. De eerste drie zijn rijen in databases die het kantoor al draait, en wie ze uit pdf's terugleest, gokt naar iets wat een tabel precies vastlegt.
Ook de afnemer verandert. Assistenten worden agents die meerdere stappen plannen en de resultaten samenvoegen, en geen enkele losse query van zo'n agent overziet de hele keten. Een agent heeft feiten nodig die blijven staan en te controleren zijn, uit één plek waar over toegang wordt beslist.
Wat een feit nodig heeft voordat er iets op steunt
In dit ontwerp komt een feit pas in de graph als er vijf dingen voor gelden.
- Het heeft een bron: een document, een bronsysteem of een partner met naam, met PROV-O-lineage ernaartoe.
- Het heeft een betrouwbaarheidsscore, en onder de drempel wacht het op een beoordelaar.
- Het heeft een beoordelingsstatus: geëxtraheerd, onbevestigd, bevestigd of afgewezen. Een afgewezen feit blijft geregistreerd en wordt nooit meer beweerd.
- Het weet wanneer het waar was. Expertise door de tijd heen is een vraag over tijd, en een graph die alleen het heden kent, kan die vraag niet beantwoorden.
- Het erft zijn beperkingen van elk dossier waaruit het is afgeleid of dat het aanhaalt, zodat een tweede stap of een samenvatting het niet kan witwassen.
SHACL-shapes controleren alle vijf bij elke load, en een load die er één schendt, komt er niet in. Dezelfde shapes houden documenttekst buiten de graph: geen enkele literal mag langer zijn dan 500 tekens. De graph bevat beweringen en identifiers. De tekst hoort bij het documentsysteem, onder zijn eigen toegangsbeheer, en een tweede kopie ervan in de graph zou de eerste bevinding zijn van elke securityreview.
Samen maken die vijf het mogelijk dat het systeem weigert. Waar de graph geen onderbouwd feit heeft, zegt het antwoord dat.
De vorm
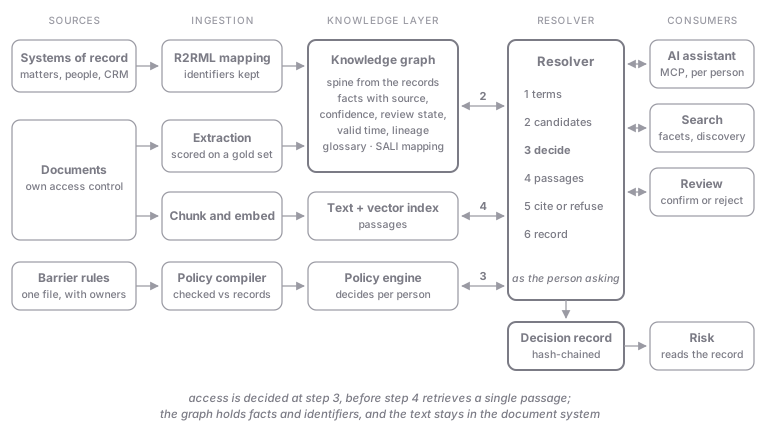
Lees het van links naar rechts. De bronnen zijn het praktijkmanagementsysteem, het CRM, HR, het documentsysteem, de eigen taxonomieën van het kantoor en de barrièreregels. De inname zet de bronsystemen in de graph met hun identifiers intact, laat een gelaagde pijplijn feiten uit documenten halen met op elk feit een betrouwbaarheidsscore, en blijft dezelfde documenten opdelen en indexeren voor zoeken. De kennislaag bevat een ontologie en een begrippenlijst in eigendom van kennismanagement, de basis van dossiers, cliënten, mensen en praktijkgebieden, de geëxtraheerde en vastgelegde feiten, een identiteitsdienst, en herkomst en toegang die in de graph worden gehandhaafd. Dan de resolver, en daarachter de afnemers: de assistent, zoeken binnen het kantoor, een werkplek voor beoordeling, een evaluatiebatterij, en Risk.
Twee keuzes in dat plaatje dragen het meeste gewicht.
De basis komt uit de bronsystemen. Dossiers, cliënten, mensen en de koppelingen van documenten aan dossiers worden met declaratieve R2RML gemapt over de live tabellen, via een databaserol die niet kan terugschrijven. Extractie hangt feiten daarna aan entiteiten die al bestaan, en hoeft nooit te beslissen of twee tekenreeksen dezelfde cliënt zijn. Een deel van de vragen waarvoor de graph bestaat, is te beantwoorden voordat er één document is gelezen. Hier wijkt het ontwerp af van Microsofts referentie-GraphRAG, dat zijn graph uit de tekst opbouwt. Eerst verankeren in de bronsystemen en pas daarna uitbreiden met extractie, dat is wat herkomst, het handhaven van barrières en een verdedigbare weigering mogelijk maakt.
De graph en de index zijn gelijkwaardig. De graph beantwoordt welke entiteiten, welke feiten, en of deze persoon ze mag kennen. De index beantwoordt welke passages het zeggen. Geen van beide staat vóór de ander. Eén resolver staat ertussen, en dat geeft één plek om een barrière te handhaven en één plek om te meten dat ze standhield.
| Laag | Open standaard | In het lab |
|---|---|---|
| Kennislaag | RDF, SKOS, een klein OWL-profiel, SHACL, PROV-O | Apache Jena Fuseki |
| Basis | R2RML over de bronsystemen | PostgreSQL als stand-in voor praktijkmanagement, CRM en HR |
| Ophalen | hybride lexicaal en vectorzoeken, gefilterd binnen de query | OpenSearch, BM25 en embeddings |
| Toegangsbeslissing | op attributen, met beslissen en handhaven gescheiden; beleid als data | Open Policy Agent |
| Documenten | de opslag handhaaft zijn eigen beleid | MinIO, één gebruiker en beleid per persoon |
| Extractie | gemeten tegen een beoordeelde gold set | Claude, via de Batches API |
| Ontsluiting | één resolver; MCP waar een standaardinterface gewenst is | één MCP-server per persoon |
| Borging | evaluatiebatterij en lektest als poort voor deployment; een hash-geketend beslisregister | make gate |
In een Microsoft-landschap krijgt de rechterkolom andere namen (Azure AI Search, Entra met on-behalf-of-tokens, Azure OpenAI), en is de triple store het enige soort onderdeel dat het landschap nog niet draait.
De volgorde is de architectuur
| Stap | Door | Wat er gebeurt |
|---|---|---|
| 1. De termen duiden | begrippenlijst | een woord met meerdere lezingen van verschillende eigenaars wordt geweigerd tot de vraag er één kiest |
| 2. Kandidaten vinden | graph | de dossiers, cliënten, mensen en feiten die de vraag raakt, alleen als identifiers |
| 3. Beslissen | beleid | per dossier, en per afgeleid feit via lineage: welke daarvan deze persoon mag zien |
| 4. Passages ophalen | index | met de toegestane set binnen de query |
| 5. Antwoorden of weigeren | resolver | verwijst naar knooppunten en documenten; een weigering noemt de regel, de eigenaar en de datum waarop die is ingesteld |
| 6. Vastleggen | resolver | één geketend record per verzoek, één keer geschreven, beantwoord of geweigerd |
Stap 3 komt vóór stap 4. De query die het bewijs oplevert, is gebonden aan de toegestane set, kan dus geen geweigerd dossier noemen, en achteraf wordt er niets meer gefilterd. Filteren na het rangschikken is precies hoe een lek ontstaat: de afgeschermde passage is dan al gekozen, gerangschikt en in de context gezet, en het filter probeert haar terug te nemen.
De resolver is een policy enforcement point, en verschilt van een API-gateway omdat zijn beslissing afhangt van het antwoord. Welke feiten de doorloop opleverde, welke dossiers ze raken, wat elk feit erfde van de feiten waaruit het voortkwam: niets daarvan is bekend voordat de graph is doorlopen, dus de autorisatie hoort waar de resultaatset wordt samengesteld. Een gateway staat er nog steeds vóór, voor TLS, tokens en rate limits. De resolver is ook geen agent. Hij plant niets en doorloopt elke keer dezelfde zes stappen in dezelfde volgorde, en juist die voorspelbaarheid maakt een evaluatie bruikbaar als poort voor deployment.
De keuzes eronder
Afbakenen met competentievragen
Het eerste product is een stuk of twintig vragen, opgesteld met de praktijkgroepen en kennismanagement, die de graph moet kunnen beantwoorden en een zoekvak niet. Ze begrenzen de ontologie, ze zijn de acceptatietests, en een relatie die geen enkele vraag nodig heeft, wordt niet geëxtraheerd. Een graph die alles beweert, is een graph waar niemand voor kan instaan. De batterij van het lab stelt 34 vragen, elk met een antwoord dat in Python uit het landschap wordt berekend en nooit uit de graph die wordt beoordeeld.
De woordenschat van het kantoor koppelen aan SALI
SALI LMSS is de voor de hand liggende basis voor een juridische ontologie. De praktijkgebieden en dossiertypen van een kantoor zijn alleen wel de manier waarop dat kantoor georganiseerd is, en kennismanagement moet ze kunnen aanpassen zonder te wachten op de volgende release van een standaard. Dus wordt elk begrip aan SALI gekoppeld met een gegradeerde SKOS-relatie (exact, dichtbij, breder, smaller), en alles wat over die koppeling redeneert, weet hoeveel vertrouwen ze verdient. In het lab was geen van de elf begrippen een exacte match. Een praktijkgroep financiële instellingen dekt banken en verzekeraars, die SALI uit elkaar haalt. SALI rekent een toezichtsonderzoek tot werk buiten geschillen, terwijl een kantoor het als procespraktijk behandelt. De namespace, gelezen uit de vastgepinde release, is http://lmss.sali.org/, en dat is niet wat iemand zou raden.
Extractie meten, en de gold set meteen mee
Extractie loopt in lagen: classificatie en metadata over alles, entiteiten en relaties op de deelverzamelingen die de vragen nodig hebben, dieper werk op verzoek. Ze wordt per relatie gescoord tegen een gold set die kennisjuristen hebben beoordeeld, en opnieuw gemeten bij elke wijziging aan de pijplijn, want een modelupgrade kan ongemerkt veranderen wat "adviseerde over" betekent. De relaties die een model mag voorstellen, liggen vast in het uitvoerschema, dus het kan geen nieuwe uitdrukken.
Reken erop dat de eerste runs fouten in de gold set vinden, en ook in het model. In het lab vonden de eerste drie runs van het rapport allemaal fouten in de gold set: sjablonen die een feit noemden dat het manifest niet meetelde, en één dat een feit kreeg toegeschreven dat er nergens in stond. Over 772 documenten is de precisie 0,96 en de recall 0,98 bij een betrouwbaarheid van 0,5, en elke verwijzing van een document naar een dossier wordt gevonden. De documenten zijn uit sjablonen geschreven, dus lees die cijfers als een bovengrens.
Samenvoegen is een beslissing
Eén vaste identifier per entiteit, matching met een betrouwbaarheidsscore, en een samenvoeging die een mens beoordeelt. owl:sameAs is een bewering, en een automatische samenvoeging die twee cliënten tot één maakt, is een incident in de conflictcheck. Tot iemand het oplost, blijft een naam zonder match ongekoppeld, waar het zichtbaar wordt als gemiste recall. In het lab blijven 50 cliënten, gespeld zoals het CRM ze spelt, ongekoppeld, omdat identiteitsresolutie buiten de scope viel.
Woorden hebben eigenaars
"Actieve cliënt" betekent vier dingen voor vier eigenaars: een cliënt met een open dossier (de praktijkgroepen), een cliënt die het afgelopen jaar is gefactureerd (Finance), een cliënt in het CRM met een relatiepartner (business development), en iedereen voor wie het kantoor ooit heeft opgetreden (Risk, omdat een conflictcheck ook oud-cliënten nodig heeft). Vier getallen. Een vraag die de term gebruikt zonder een lezing te kiezen, wordt bij stap 1 geweigerd, met de lezingen erbij. Gesteld via Claude Code doet het model wat de weigering zegt: het toont de vier en vraagt welke bedoeld is. Elke term heeft een eigenaar met naam binnen kennismanagement of een praktijkgroep, en een term veranderen is een verzoek met een beoordelaar.
Waar filteren op documentniveau ophoudt te werken
De gebruikelijke maatregel in een juridische opzet voor ophalen is de toegangslijst van het documentsysteem zelf: alleen passages uit documenten die iemand mag openen, komen terug. Op een eenvoudig corpus houdt dat stand. In het lab lekte achter een filter op documentniveau geen enkel gewoon document, omdat geen ervan naar een ander dossier verwees.
Kantoren schrijven ook kennisnotities. Een precedentnotitie, gearchiveerd op een open dossier, noemt het dossiernummer, de cliënt en de uitkomst van een afgeschermd dossier. Het documentsysteem opent haar, want ze staat op een open dossier, en elk filter dat kijkt naar het dossier waarop een document is gearchiveerd, laat haar door. Bij 16 vragen over precedent en over cliënten met naam bracht ophalen zonder filter alle 16 keer afgeschermde inhoud voor het model. Met een filter op documentniveau ook 16 keer. Met het lineage-filter van de graph geen enkele keer.
De oplossing is lineage. De geëxtraheerde feiten van een notitie zijn afgeleid van elk dossier dat ze aanhaalt, dus de notitie en haar feiten zijn afgeschermd overal waar een van die dossiers dat is. De index slaat bij elke passage alle dossiers op waarvan ze afhangt, en het filter eist dat ze allemaal zijn toegestaan. Dat werkt alleen als extractie elke verwijzing vindt, en daarom telt de recall op verwijzingen hierboven zwaarder dan elk ander getal in het extractierapport.
De documentopslag houdt zijn eigen slot. Bij elke verwijzing hoort een link naar de pdf, vijf minuten geldig en ondertekend met de eigen inloggegevens van de advocaat die vraagt, en een document-id dat op een andere manier is verkregen, levert niets op: de opslag weigert het op zijn eigen beleid, gecompileerd uit hetzelfde regelbestand als dat van de graph. De twee zijn het niet overal eens. De opslag kan niet weten wat een document aanhaalt, dus bij 15 notities is ze zwakker dan de graph. De poort controleert over 3.860 combinaties van persoon en document dat de graph nooit ruimer is dan de opslag, en meldt de 15 als bevinding.
Over de volledige batterij van 34 vragen was het vectorpad achter een filter op documentniveau 10 keer juist, weigerde het 2 keer, zat het 9 keer stellig fout en lekte het 13 keer. Het graphpad via de resolver was alle 34 keer juist en lekte nooit. Het zijn competentievragen, per definitie terrein van de graph, dus de vergelijking bevoordeelt de graph. Zoeken houdt de lange staart, de precieze formulering ("hoe hebben we die uitzondering op de vrijwaring verwoord?"), gelijkenis, en nieuwe onderwerpen voordat de ontologie er een woord voor heeft. Wat de graph overneemt, is de beslissing wat zoeken mag teruggeven.
Hieruit komen twee instellingen, en die zijn van het kantoor. De eerste is of een afgeschermde advocaat te horen krijgt dat er iets is achtergehouden: nuttig voor die advocaat, en tegelijk een onthulling van één bit. Beide varianten zijn gebouwd, en wie de vraag stelt, kan er niet tussen kiezen. De tweede is of een telling over dossiers waarvan iemand is afgeschermd, wordt geweigerd, of berekend over wat die persoon wel mag zien en zo gelabeld. Weigeren is veilig, en in het lab maakte het elke kantoorbrede telling voor iedereen onbeantwoordbaar, omdat elke advocaat ergens van is afgeschermd. In een kantoor met honderden dossiers op need-to-know-basis zou elke kantoorbrede maatstaf dezelfde kant op gaan. Die beslissing staat nog open.
Het register van een barrière
Elk verzoek schrijft één record, één keer, bij afronding, met de records aan elkaar geketend via hashes. Het register van een barrièresysteem is zelf vertrouwelijk: een regel die zegt dat deze advocaat dat dossier is geweigerd, vertelt de lezer precies wat de barrière verbergt. Daarom staan afgeschermde identifiers in elk veld als gezouten hashes, ook de woorden die de advocaat intypte, en wordt vrije tekst helemaal niet bewaard.
Alleen Risk mag het register lezen, besloten door dezelfde policy-engine, en ook wat Risk leest, komt in dezelfde keten. Risk kan de drie vragen beantwoorden die zich voordoen (wie kreeg ooit iets te zien dat van dit dossier is afgeleid, wat zag deze advocaat, waarom werd dat verzoek geweigerd) en krijgt dezelfde gronden die de advocaat destijds te zien kreeg, teruggelezen uit hetzelfde record. De keten maakt een wijziging of verwijdering zichtbaar. Ze kan niet laten zien dat haar staart is afgeknipt, dus de laatste hash moet ergens anders worden bewaard.
Wat het bouwen opleverde
Twee bevindingen uit de bouw zijn meer waard dan de getallen.
De barrièretest stelt 250 vragen: elke regel, elke persona, rechtstreeks, via een tweede stap, via lineage en als telling. Een vroege versie bepaalde wie geweigerd moest worden door het gecompileerde beleid te lezen, en keurde zo een gemanipuleerd beleid goed, omdat de test het met zichzelf eens was. Nu berekent hij de verwachting rechtstreeks uit het regelbestand en de bronsystemen, buiten de compiler en de policy-engine om. Met de hand gedraaid, met één afscherming alleen uit het gecompileerde beleid gehaald, meldde hij zes lekken, twee onterechte weigeringen en veertien leesbare identifiers in het register.
De eerste Claude Code-sessie tegen het lab vond iets waar de test nooit naar had gekeken. De eigen beschrijving van een persona, teruggegeven door whoami(), noemde het dossier waarvan ze was afgeschermd. De test controleert nu alles wat een sessie te zien krijgt, ook wat haar over zichzelf wordt verteld.
Wat het lab niet kan zeggen
Het draait op laptopschaal en zegt niets over doorvoer, kosten of latentie. Identiteit wordt verklaard: de container van elke persona bevat een sleutel en maakt een kortlevende verklaring aan, waar een kantoor een on-behalf-of-flow tegen zijn identity provider zou gebruiken, en dat is de enige plek waar het lab zwakker is dan het ontwerp. De documenten zijn uit sjablonen geschreven, dus hun proza is regelmatiger dan die van een kantoor. Twee oordelen komen van een model, de antwoorden van het vectorpad en de beoordeling daarvan, en elk lek wordt mechanisch geteld.
Wat overdraagbaar is, is de volgorde. Eerst de bronsystemen, de regels als data met eigenaars, een beslissing vóór elk ophalen, en een register dat zelf achter een barrière staat. Het regelbestand, de begrippenlijst en de SALI-koppeling zijn YAML die een kennismanager of een risk officer kan lezen en beheren, en ze gaan langer mee dan welke opslag er uiteindelijk onder komt te liggen.